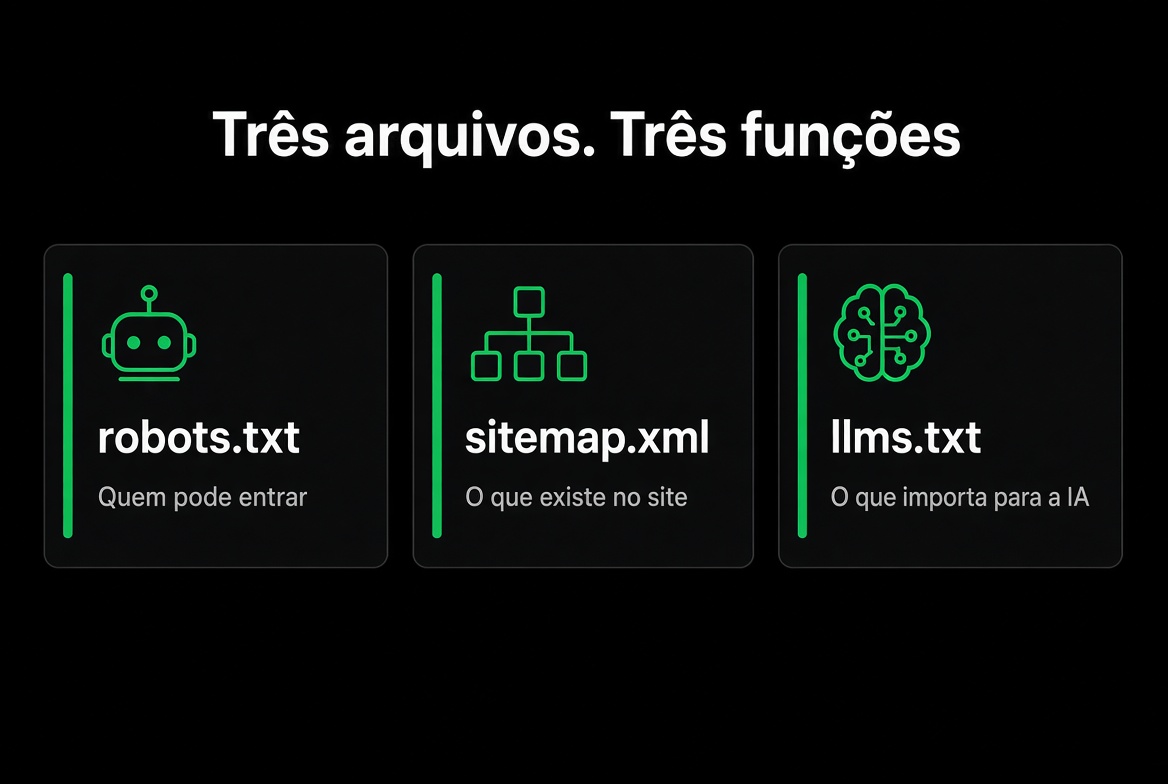
Três arquivos. Três empregos. Uma confusão só.
Muita empresa mistura robots.txt, sitemap.xml e llms.txt como se fossem variações da mesma ideia. Não são. Cada um resolve um problema diferente na conversa entre o site e as máquinas — buscadores, crawlers e, agora, agentes de IA.
Neste artigo você vai sair com a função de cada arquivo clara, saber o que acontece quando um está errado e entender onde o MCP entra (spoiler: em outra camada).
Por que a confusão é comum
Os três:
- Ficam (ou podem ficar) em caminhos previsíveis na raiz ou em locais conhecidos
- São textos "para máquina"
- Aparecem em checklists de SEO e, agora, de GEO
Aí nasce o atalho mental: "é tudo arquivo de IA/SEO".
Na prática, misturar os papéis gera erro clássico: liberar sitemap e achar que o bot da IA está autorizado; ou criar llms.txt e achar que o Googlebot foi configurado.
robots.txt — a porta de entrada
Função: dizer aos crawlers o que podem ou não podem acessar.
- Caminho típico: seusite.com.br/robots.txt
- Público: Googlebot, Bingbot, GPTBot, ClaudeBot, PerplexityBot, Google-Extended, etc.
- Lógica: Allow / Disallow por User-agent
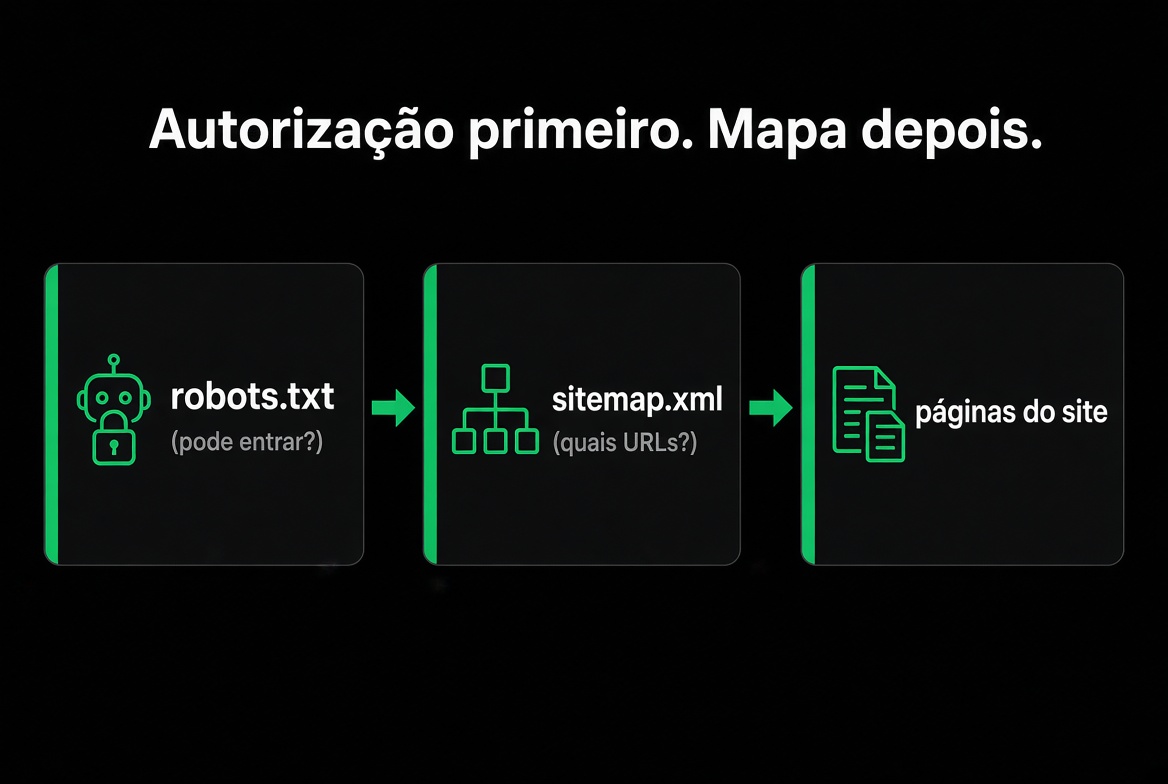
Se o robots.txt bloqueia os bots das IAs com regras amplas, o resto da estratégia enfraquece: a máquina nem chega nas páginas que você otimizou.
É a camada de rastreabilidade — a base da pirâmide que já detalhamos no artigo sobre robots.txt e os bots das IAs.
sitemap.xml — o mapa do terreno
Função: listar URLs relevantes do site para ajudar buscadores a descobrir e priorizar páginas.
- Caminho típico: seusite.com.br/sitemap.xml (ou índice de sitemaps)
- Público principal: crawlers de busca (Google, Bing...)
- Conteúdo: URLs, às vezes lastmod, prioridade, frequência
O sitemap não autoriza acesso (isso é robots).
Ele também não explica "o que a empresa vende" em linguagem de oferta.
Ele responde: "estas páginas existem e merecem ser consideradas."
Site grande sem sitemap costuma ser descoberto de forma mais lenta e irregular. Site com sitemap e robots bloqueando tudo continua invisível.
llms.txt — o índice curado para IAs
Função: oferecer um resumo e mapa editorial do que a empresa é e quais recursos importam, em formato legível por humanos e agentes.
- Caminho típico: seusite.com.br/llms.txt
- Público: agentes de IA e ferramentas que procurem esse padrão
- Conteúdo: identidade, ofertas, links prioritários, contato — em Markdown/texto
O llms.txt não substitui robots (não libera bot).
Não substitui sitemap (não lista o site inteiro de forma sistemática).
Não substitui catálogo JSON nem MCP (não é base de preço/estoque consultável).
Ele responde: "se você é uma IA, comece por aqui para me entender."
Comparativo
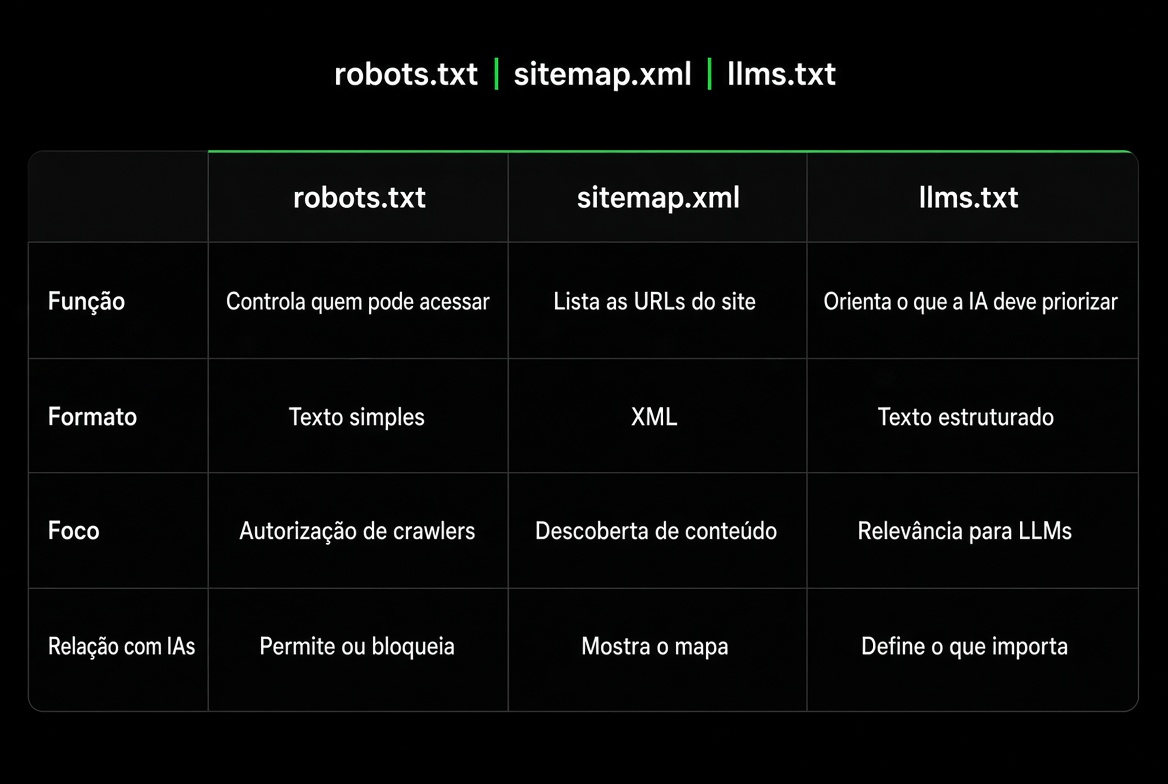
Pergunta que responde
- robots.txt: Posso crawlear isto?
- sitemap.xml: Quais URLs existem?
- llms.txt: O que esta empresa é e o que importa?
Formato
- robots.txt: Diretivas de user-agent
- sitemap.xml: XML de URLs
- llms.txt: Markdown/texto
Foco principal
- robots.txt: Autorização de acesso
- sitemap.xml: Descoberta de páginas
- llms.txt: Contexto e índice curado
SEO clássico
- robots.txt: Crítico
- sitemap.xml: Muito importante
- llms.txt: Complementar
GEO / agentes
- robots.txt: Crítico (bots de IA)
- sitemap.xml: Útil
- llms.txt: Útil, limitado sozinho
Substitui MCP?
- robots.txt: Não
- sitemap.xml: Não
- llms.txt: Não
O que cada um NÃO faz
robots.txt não:
- Garante indexação ou citação
- Descreve produtos e preços
- Substitui autenticação de áreas privadas (é pista, não segurança forte)
sitemap.xml não:
- Obriga o Google a ranquear
- Libera bot bloqueado no robots
- Explica posicionamento de marca
llms.txt não:
- Garante requisições dos agentes (muitos arquivos recebem pouco ou nenhum hit)
- Substitui Schema, autoridade ou MCP
- Corrige site genérico e confuso
Tratar qualquer um como "solução completa de IA" é o atalho que mais gera frustração.
Ordem prática de prioridade
Para a maioria das empresas:
- robots.txt — garantir que os bots certos entram
- Clareza das páginas — o que os bots encontram precisa fazer sentido
- sitemap.xml — facilitar descoberta sistemática (SEO + higiene técnica)
- Schema — entidades explícitas
- llms.txt — índice curado
- MCP + ai-catalog + server.json — consulta e inventário vivo
Sem o passo 1, os passos 5 e 6 perdem força.
Com o passo 1 ok e páginas ruins, sitemap e llms só aceleram a descoberta de conteúdo fraco.
Onde entram Schema e MCP
robots.txt Papel: autoriza o acesso.
sitemap.xml Papel: lista URLs.
Schema / JSON-LD Papel: declara entidades na página.
llms.txt Papel: resume e prioriza.
ai-catalog.json Papel: inventário estruturado.
server.json + MCP Papel: conexão e consulta ao vivo.
A Scrypta atua a partir da geração dos arquivos de catálogo/manifesto e do MCP Server (e pode incluir llms.txt no pacote de artefatos).
Ela não substitui a obrigação de ter robots.txt correto no seu domínio — isso continua sendo configuração do seu site.
Por isso o diagnóstico e o checklist sempre começam em rastreabilidade. Se quiser entender o que cada arquivo estruturado faz, leia ai-catalog.json e server.json: para que servem e como criar um llms.txt que realmente ajuda.
O próximo passo
Antes de criar mais um arquivo na raiz, responda:
- Meu robots.txt bloqueia GPTBot, ClaudeBot, PerplexityBot ou Google-Extended?
- Meu sitemap.xml reflete as páginas que realmente importam?
- Meu llms.txt (se existir) é factual ou só marketing?
- Eu tenho inventário consultável (catálogo/MCP) ou só texto?
O diagnóstico gratuito da Scrypta ajuda a ver o quadro de legibilidade:
- Rastreabilidade
- Dados estruturados
- Presença de llms.txt
- Legibilidade geral para agentes de IA
Leva cerca de 15 segundos.