O llms.txt ganhou o holofote. Os outros dois arquivos fazem o trabalho pesado.
Muita empresa descobre o llms.txt, publica um Markdown na raiz e acha que encerrou a conversa de "dados para IA". Na pilha completa de legibilidade — e no que a Scrypta entrega — existem pelo menos mais dois artefatos críticos: ai-catalog.json e server.json.
Neste artigo você vai entender o papel de cada um, por que o llms.txt não os substitui e como os três se encaixam com o MCP Server.
Os três arquivos e o endpoint
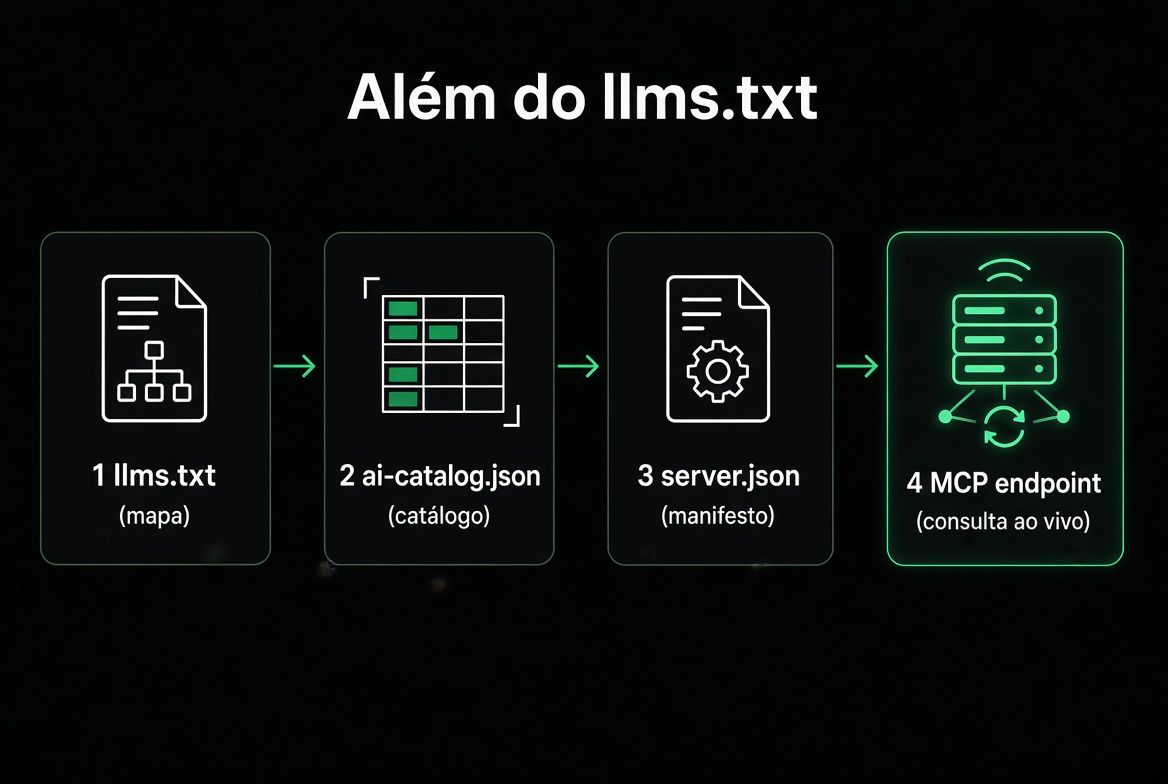
Na prática, a pilha mínima "séria" para ficar legível e consultável envolve:
llms.txt Tipo: texto/Markdown Função principal: mapa e identidade legível por humanos e máquinas.
ai-catalog.json Tipo: JSON Função principal: catálogo estruturado (produtos/serviços, preço, etc.).
server.json Tipo: JSON Função principal: manifesto do MCP Server para o Registry.
MCP endpoint Tipo: API/protocolo Função principal: consulta ao vivo dos dados.
Sem o JSON de catálogo, o agente depende demais de texto livre.
Sem o server.json, o registro oficial e a descoberta padronizada ficam incompletos.
Sem o endpoint, sobram arquivos estáticos — úteis, mas não "consultáveis" em tempo real.
O que o llms.txt faz (e onde para)
O llms.txt funciona como placa de entrada + índice curado:
- Quem é a empresa
- O que oferece
- Quais páginas importam
- Como falar com ela
Ele é excelente para dar contexto.
Ele não é um banco de dados de SKUs, preços e estoque.
Limitações típicas:
- Não escala bem para centenas ou milhares de itens detalhados
- Não substitui consulta filtrada ("até R$ 100", "categoria X")
- Não registra o servidor no MCP Registry
- Sozinho, não cria ferramentas chamáveis por agentes
Por isso estudos que medem requisições a llms.txt mostram uso limitado quando o arquivo é tratado como solução isolada: ele ajuda, mas não carrega a operação inteira. Se quiser entender o que ele faz bem, leia como criar um llms.txt que realmente ajuda.
O que é o ai-catalog.json
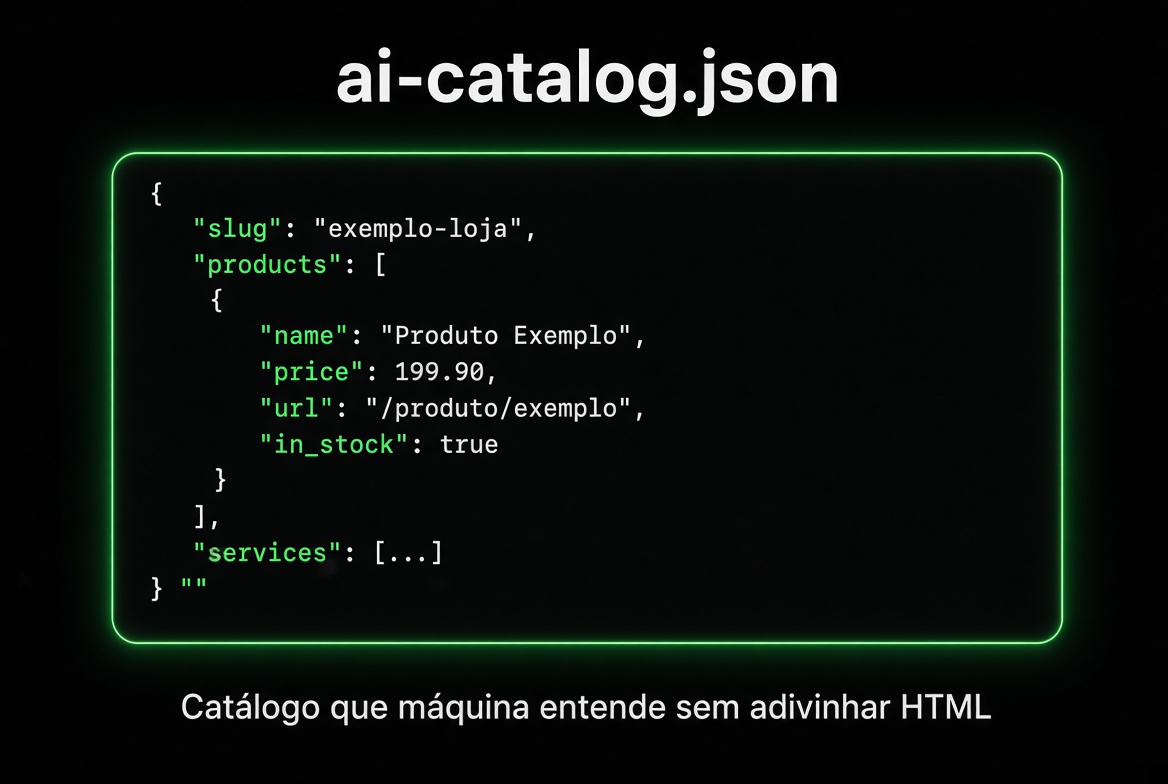
O ai-catalog.json é o catálogo em linguagem de máquina.
Em vez de o agente tentar extrair preço de HTML, ele encontra uma estrutura previsível, por exemplo:
- Identificação do tenant/slug e URL da empresa
- Estatísticas (quantidade de produtos, categorias)
- Lista de itens com nome, preço, URL, disponibilidade, categoria
Para e-commerce: produtos, preços, estoque quando disponível.
Para serviços: lista de serviços/planos adaptada ao mesmo espírito estruturado.
É o arquivo que responde, com precisão, a perguntas de catálogo — e que alimenta a lógica do MCP Server.
O que é o server.json
O server.json é o documento de identidade do MCP Server.
Ele descreve, no padrão esperado pelo ecossistema:
- Nome do servidor
- Como conectar (URL do endpoint, tipo de transporte, ex. streamable-http)
- Metadados exigidos pelo schema do Registry
Sem server.json válido, a publicação no MCP Registry oficial não se completa direito.
Com ele, o servidor deixa de ser só "uma URL que alguém colou no Slack" e passa a ter manifesto padronizado.
Analogia:
- ai-catalog.json → o estoque documentado
- server.json → a ficha cadastral do balcão (MCP) na lista oficial
Se quiser aprofundar o papel do Registry, leia MCP Registry oficial: o que é e por que estar listado importa.
Como os três trabalham juntos
Fluxo mental simples:
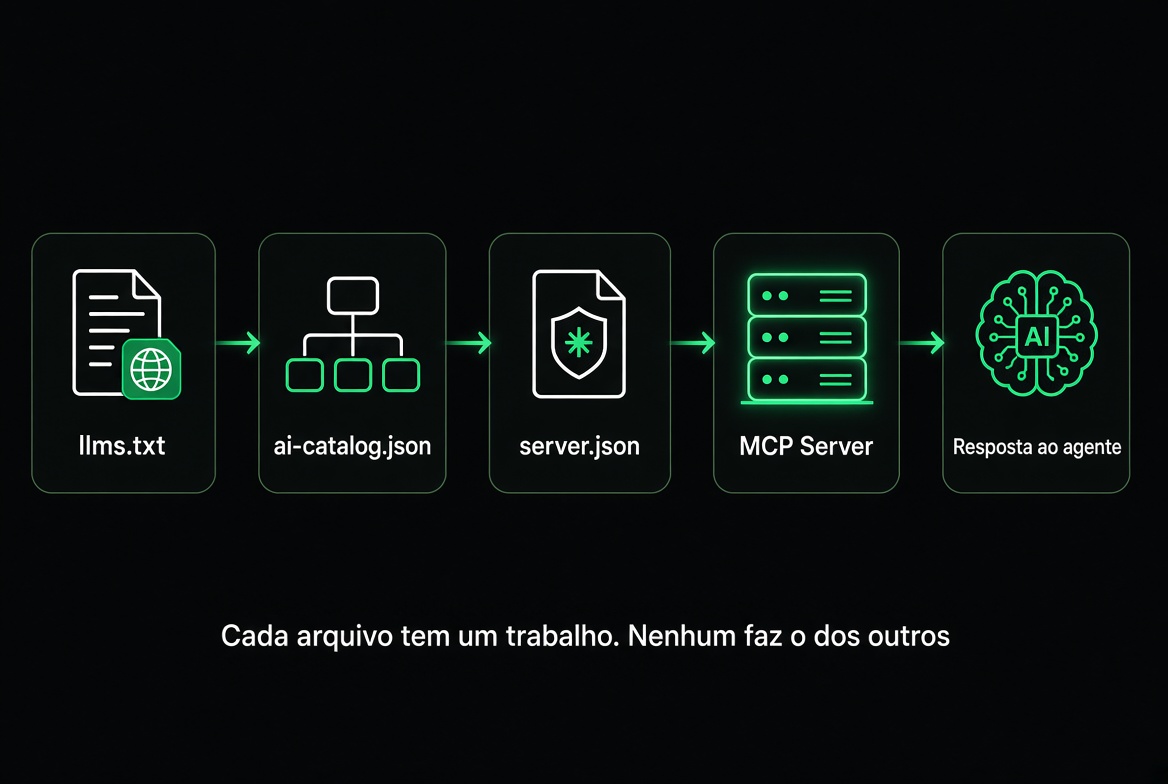
- llms.txt — "O que é esta empresa e por onde começar?"
- ai-catalog.json — "Quais itens/serviços existem e com quais dados?"
- server.json — "Como um agente se conecta ao servidor MCP desta empresa?"
- MCP endpoint — "Execute a busca/filtro e devolva o resultado atualizado."
O llms.txt orienta.
O ai-catalog materializa o inventário.
O server.json habilita a descoberta e a conexão formal.
O MCP realiza a consulta.
Tirar qualquer peça enfraquece a pilha. Trocar tudo por um único Markdown é o atalho mais comum — e o mais incompleto.
Exemplos do que cada um responde
Entender o posicionamento em 30 segundos Melhor artefato: llms.txt
Listar produtos com preço Melhor artefato: ai-catalog.json / MCP
Filtrar "até R$ 100" Melhor artefato: MCP (apoiado no catálogo)
Saber a URL de conexão do servidor Melhor artefato: server.json
Registrar no Registry oficial Melhor artefato: server.json + endpoint no ar
Descobrir páginas institucionais importantes Melhor artefato: llms.txt
Perceba: perguntas de compra e filtro quase nunca são bem resolvidas só com llms.txt.
Erros comuns
- Publicar só llms.txt e declarar "estamos prontos para IA"
- Gerar JSON na mão sem pipeline de atualização — preço vira mentira em uma semana
- server.json apontando para endpoint fora do ar
- Catálogo incompleto (só 10 produtos de 500) tratado como verdade total
- Misturar dado interno sensível no JSON público
- Achar que ai-catalog.json substitui autoridade de marca
- Duplicar informações conflitantes entre site, llms.txt e JSON
Arquivo bom com governança fraca vira risco reputacional rápido.
Como a Scrypta gera e publica esses arquivos
No fluxo Scrypta (detalhado em o que acontece nos bastidores do Scrypta MCP Server):
- Extrai catálogo ou serviços do site
- Gera llms.txt, ai-catalog.json e server.json
- Publica em scrypta.com.br/p/seu-slug/...
- Sobe o MCP em scrypta.com.br/mcp/seu-slug
- Usa o server.json no registro do MCP Registry oficial
- Mantém hospedagem e linha de atualização do catálogo
Você não precisa montar a esteira de geração nem validar schema do Registry na mão. Os três arquivos deixam de ser "tarefa de desenvolvedor" e passam a ser entregável do produto.
Se quiser ver o que o MCP entrega na prática depois de tudo montado, leia MCP Server na prática: o que a IA consegue perguntar.
O próximo passo
Se a sua estratégia de IA parou no llms.txt, faltam o inventário estruturado e o manifesto do servidor.
O diagnóstico gratuito da Scrypta mostra o estado atual de legibilidade:
- Rastreabilidade
- Dados estruturados
- Presença de llms.txt
- Legibilidade geral para agentes de IA
Leva cerca de 15 segundos. A partir daí, fica claro se o próximo passo é só conteúdo — ou a pilha completa com ai-catalog.json, server.json e MCP.